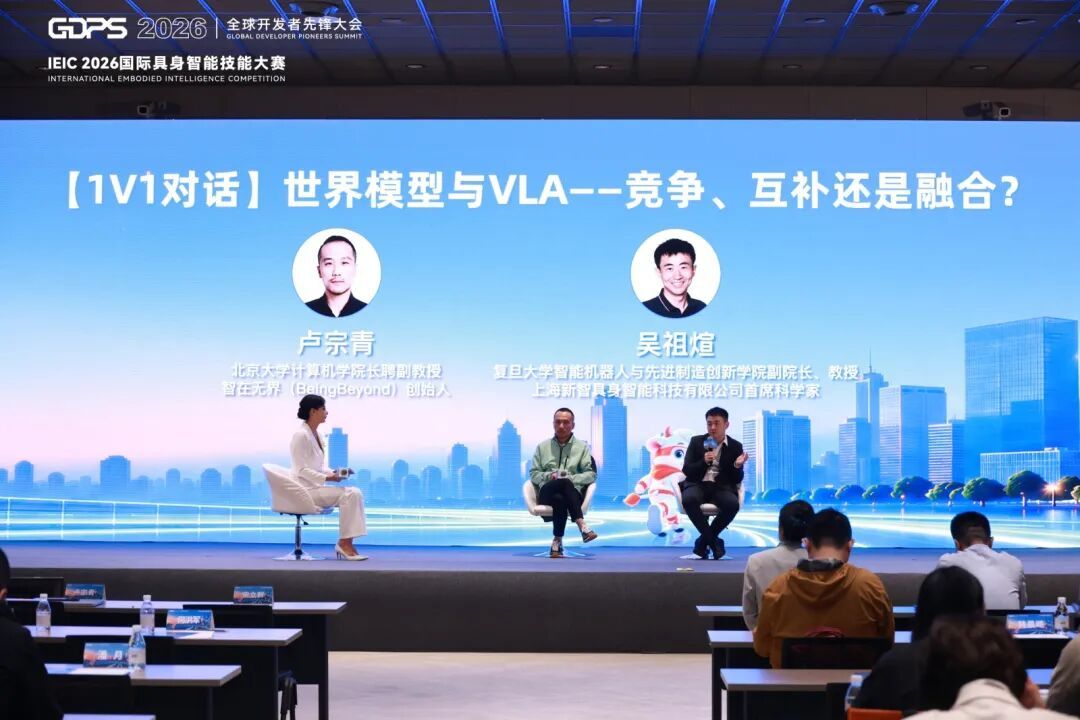
在近期GDPS“汇智具身,向新而来”具身智能先锋讲坛的1V1对话中,卢宗青、吴祖煊两位行业专家围绕两条路线的优劣势、融合边界展开交锋。
从理论构想上,大一统具身模型看似前景诱人,但结合算力约束、物理交互短板、真实真机落地难题来看,当下行业距离范式统一仍有很远距离。
真正的行业进展,更多来自不同路线之间思想借鉴与能力补齐,而非简单的架构合并。
01 博弈的三个分歧,System1执行、物理感知与数据
其实,有关路线的争论,表面是模型架构之争,本质是机器人需要优先解决哪一类核心短板的认知分歧。
比如,卢宗青提出,GPT‑6 Astra的出现,一定程度消解了VLA与世界动作模型的路线矛盾。Astra这类大模型可以充当System2,负责高层逻辑推理、任务规划;而机器人真正稀缺的是System1高频动作控制系统,负责高频输出动作完成实体作业。对于大多数具身创业企业,并不具备头部大模型厂商的巨量算力,强行复刻超大VLA模型并不现实。
无论是VLA叠加动作专家,还是世界动作模型,都只是通往System1能力的不同实现路径。当前VLA和世界模型共同的痛点,是零样本泛化能力偏弱,如何在复杂三维物理环境下完成泛化,是整个行业共同攻关的目标。
吴祖煊则把视角落脚在物理世界感知闭环。他认为,即便大模型可以依靠Code as Policy完成机器人任务,但纯视觉驱动执行任务耗时漫长,缺少触觉、力反馈这类物理层面的信息输入。
视觉、听觉感知已经成熟,但力反馈是物理交互的明显短板。具身智能需要构建“感知‑行动‑反馈”完整闭环,依靠环境交互拿到真实反馈迭代模型,才能实现零样本、少样本的任务适配。触觉不是简单附加的插件,一方面可以约束机器人的动作力度,避免夹碎物体等事故;另一方面捕捉物体被操作之后的物理状态变化,为模型迭代提供真实信号。
路线分歧同样体现在数据策略上。一边是50万小时人本第一视角视频预训练的思路,另一边看重真机数据、仿真生成数据协同的“数据金字塔”。
大家已经形成共识:预训练需要保证样本广度,下游任务依靠真机数据微调。但具身领域最大的现实困境在于评测难。大模型可以依靠标准化基准测试评估效果;而具身模型必须真机实测,更换硬件、场景性能就会出现明显波动,仿真‑现实之间存在难以抹平的鸿沟,行业至今没有形成公认的评测标准,也进一步延缓了大一统范式的诞生。
02 拒绝简单拼接,有价值的是能力借鉴,而非架构强行融合
不少舆论畅想,未来会出现一款把VLA和世界模型直接拼接起来的“融合大模型”,但两位专家均认为,底层架构强行合并并非正确方向。
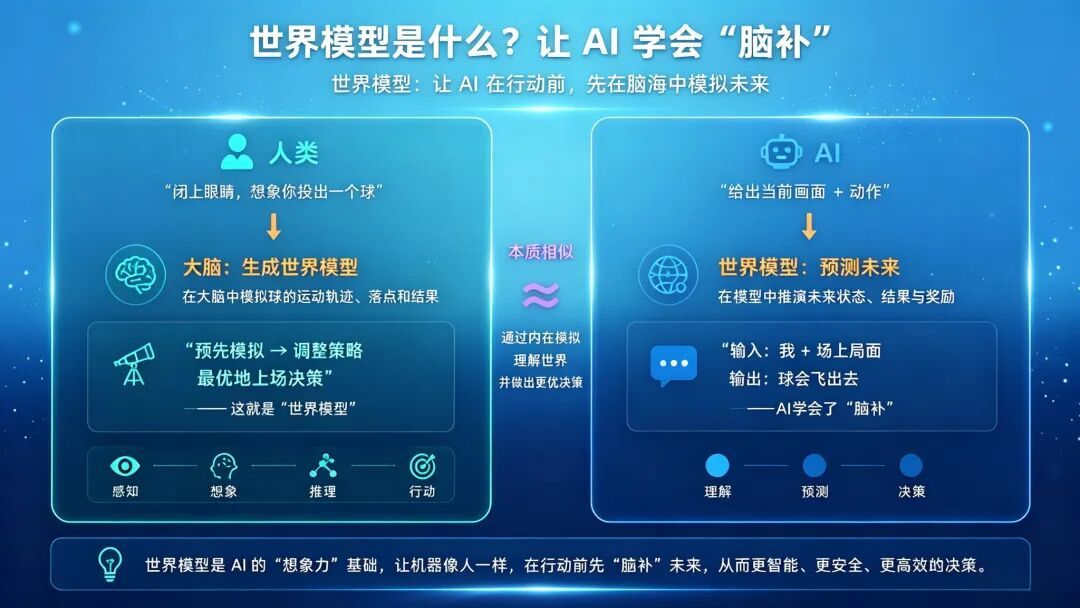
有业内人士认为,VLA、世界模型只是不同训练手段与骨干网络架构,未来行业会自然收敛到最优的一套技术,而不是把两个概念简单拼凑。真正值得期待的融合,不是架构的混合,而是System1动作执行模块和System2高层推理大模型的能力融合。System1负责高频实体动作输出,System2负责任务推理规划,二者结合支撑递归自主学习、在线强化学习,才是具身技术的核心发展方向。
还有人同样不看好底层架构的强行合并。技术上可以互相吸收高层思想,比如将世界模型的视觉预测思维链引入VLA的规划控制链路,但短期不会发生底层架构的合并。高昂训练成本也成为大一统范式的现实阻碍,AMI Labs高估值、World Labs巨额收购案、英伟达Cosmos高昂训练成本都印证,百亿参数级别具身模型训练代价极高。
与此同时,商业化现实进一步压缩了大一统模型的落地空间。短期市场会大量涌现垂类小模型,部分模型参数甚至不足2B,聚焦单一工位,只要投入产出比跑通就可以落地。通用System1模型何时成熟仍存在不确定性,卢宗青给出的乐观预期是未来18个月实现较强的零样本泛化能力,但也直言,仅靠GPT‑6这类大模型做机器人控制,就如同高级程序员写代码,耗时长、泛化有限,无法直接承担落地重任。
长远看,具身智能未必会走向“一套模型打天下”。比起追逐大一统范式,行业更务实的方向是吸收不同路线的长处,补齐高频动作、物理感知、真机反馈、商业化落地的短板,让技术适配真实产业场景。
背靠深圳市物联网产业协会,【机器风潮】关注前沿机器人讯息,包括但不限于具身智能、人形机器人、协作机器人、服务机器人等。平台试图给行业从业者构建更高密度、更具价值的圈子。【机器风潮】正在组建各类行业群聊,以及行业活动,欢迎扫码添加工作人员加入。